|
|
||
Рецензия на авторский метод Рублевского А.В. - артикуляторно-семантический инициальный профиль лексем языка. | ||
РЕЦЕНЗИЯ НА СТАТЬЮ: АРТИКУЛЯТОРНО-СЕМАНТИЧЕСКАЯ РЕКОНСТРУКЦИЯ И ТРАНСФОРМАЦИЯ ИНИЦИАЛЬНЫХ ПРОФИЛЕЙ ЛЕКСЕМ РОДСТВА: ПРАБОРЕЙСКОГО, ПРАИНДОЕВРОПЕЙСКОГО, ШУМЕРСКОГО, ГОТСКОГО, ВЕДИЙСКОГО, РУССКОГО, АРМЯНСКОГО и ФРАНЦУЗСКОГО ЯЗЫКОВ
https://samlib.ru/r/rublewskij_a_w/artikuljatorno-semanticheskajarekonst.shtml
Автор: Рублевский А.В. - магистр исторических наук, исследователь в области экономических наук, инженер-программист.
Метод: авторский метод Рублевского А.В. - артикуляторно-семантический инициальный профиль лексем языка.
АННОТАЦИЯ
В настоящей статье представлен артикуляторно-семантический анализ исторической динамики лексики родства на основе авторского метода Рублевского А.В. - метода артикуляторно-семантического инициального профиля. Метод исходит из предположения, что начальная согласная или согласный комплекс лексемы, соотнесённой с определённым базовым концептом, может быть отнесён к одному из трёх артикуляторно-семантических классов: гортанному (ʔ), губному (W) или переднеязычному (T).
В работе применяется раздельная двухэтапная процедура. На первом этапе определяется степень сохранения артикуляторного класса при переходе от праборейского (ПБ) предполагаемого уровня к праиндоевропейскому (ПИЕ). На втором этапе независимо определяется сохранение ПИЕ-профиля в языках-потомках. Для шумерского языка, который в рамках принятой модели не рассматривается как индоевропейский, применяется непосредственное сопоставление ПБ → шумерский. Коэффициенты отдельных этапов не перемножаются, поскольку они характеризуют различные исторические переходы.
Для количественной оценки вводится коэффициент сохранения:
КС = (число концептов, сохранивших артикуляторный класс / общее число анализируемых концептов) × 100%.
На матрице из 12 базовых концептов родства для перехода ПБ → ПИЕ сохраняется 8 из 12 профилей, что соответствует 66,7%. Для прямого перехода ПБ → шумерский также фиксируется 8 из 12 совпадений, или 66,7%. Для ПИЕ → готский в принятой выборке сохраняется 12 из 12 позиций, для ПИЕ → ведийского 9 из 12, для ПИЕ → русского и ПИЕ → армянского по 7 из 12, для ПИЕ → французского 6 из 12.
Полученные результаты рассматриваются как показатель степени сохранения или изменения артикуляторно-семантической структуры выбранного лексического поля. При этом коэффициент сохранения сам по себе не доказывает генетическое родство языков и не должен отождествляться с обычным лингвистическим критерием этимологического родства.
Ключевые слова: артикуляторно-семантический инициальный профиль, артикуляторная семантика, артикуляторно-семантический анализ, инициальный профиль, праборейский, праиндоевропейский, шумерский, родство, коэффициент сохранения, конвергенция, историческая лингвистика.
1. ВВЕДЕНИЕ
Исследование исторической лексики родства традиционно строится преимущественно на этимологическом, фонетико-сравнительном и морфологическом анализе. В настоящей работе предлагается дополнительный способ представления материала - через артикуляторно-семантическое кодирование начальных позиций лексем.
Основой подхода является метод Рублевского, или метод артикуляторно-семантического инициального профиля. Его принцип заключается в том, что начальная согласная позиция слова рассматривается не только как фонетическая характеристика, но и как формальный элемент, который в пределах исследовательской модели может быть соотнесён с определённым семантическим классом.
В данной версии метода используются три основных класса:
В интерпретационной части исследования данным классам сопоставляются соответственно:
Такое соотношение является модельной семантической интерпретацией, а не утверждением о том, что фонема сама по себе обладает лексическим значением. Поэтому принципиально важно различать два уровня анализа:
Метод Рублевского таким образом может быть представлен как последовательность:
лексема → начальная согласная позиция → артикуляторный класс → профиль концепта → сравнение исторических срезов.
Исследование посвящено концептам родства, поскольку они относятся к числу наиболее устойчивых элементов базовой лексики и одновременно демонстрируют широкое разнообразие исторических преобразований.
2. ХРОНОЛОГИЧЕСКИЙ И ТЕОРЕТИЧЕСКИЙ КАРКАС
В исследовании используются следующие исторические уровни:
Язык / уровень | Условная датировка |
Праборейский (ПБ) | - 15 000 - 12 000 лет до н. э. |
Праиндоевропейский (ПИЕ) | - 4 500 - 2 500 гг. до н. э. |
Шумерский | - 3 500 - 2 000 гг. до н. э. |
Ведийский санскрит | - 1 500 - 1 000 гг. до н. э. |
Готский | - 300 - 500 гг. н. э. |
Армянский (грабар) | - 400 - 1000 гг. н. э. |
Русский | преимущественно исторический и современный материал |
Французский | преимущественно исторический и современный материал |
Данные датировки используются как исследовательский хронологический каркас. Они не означают, что все указанные языки существовали в конкретной реконструированной форме именно в пределах одного узкого временного интервала.
Для праборейского уровня речь идёт о гипотетическом макросемейном реконструкционном уровне. Следовательно, результаты анализа ПБ должны рассматриваться как модельные и зависимые от принятой реконструкции.
3. АВТОРСКИЙ МЕТОД РУБЛЕВСКОГО А.В.
3.1. Основной принцип
Метод Рублевского основан на анализе инициального артикуляторного профиля лексем.
Для каждого исследуемого концепта выполняются следующие операции:
Таким образом, метод не требует совпадения полного фонетического облика слова. Сопоставляется прежде всего класс начальной позиции.
3.2. Артикуляторные классы
Класс ʔ - гортанный
В принятой системе к нему относятся начальные позиции, связанные с гортанной зоной артикуляции, включая реконструируемые ларингальные элементы.
Интерпретационно класс ʔ связывается с:
Класс W - губной
К W относятся губные согласные и соответствующие губные позиции.
Интерпретационно W связывается с:
Класс T - переднеязычный
К T относятся переднеязычные и соответствующие им позиции.
В рамках модели T связывается с:
При этом семантическая интерпретация должна применяться после формального кодирования и не смешиваться с ним.
4. ФОРМАЛИЗАЦИЯ КОДИРОВАНИЯ
Для каждого понятия мы смотрим, сохранился ли его артикуляторный класс при переходе от одного языка к другому.
Если класс сохранился, ставим 1.
Если класс изменился, ставим 0.
После этого подсчитываем, сколько понятий сохранили свой класс, и сравниваем это число с общим количеством исследуемых понятий.
В этой статье рассматриваются 12 понятий родства. Поэтому коэффициент сохранения (КС) рассчитывается так:
КС = количество сохранённых понятий / 12 × 100%.
Например, если из 12 понятий сохранили свой артикуляторный класс 8, то:
КС = 8 / 12 × 100% = 66,7%.
Таким образом, коэффициент сохранения показывает, какая доля исходного артикуляторного профиля сохранилась на следующем историческом этапе.
Поэтому:
Ключевой методологический принцип состоит в том, что коэффициенты разных исторических переходов не перемножаются.
Например, на первом этапе мы получаем:
ПБ → ПИЕ = 66,7% сохранения.
Это означает, что при переходе от праборейского уровня к праиндоевропейскому сохранилось 8 из 12 исследуемых артикуляторных профилей.
Затем отдельно рассматривается следующий переход:
ПИЕ → готский = 100% сохранения.
Это означает, что все 12 профилей, которые мы используем на праиндоевропейском уровне, сохранились в готском материале.
Эти два показателя нельзя просто перемножать, поскольку они описывают два разных исторических перехода.
Их сравнение позволяет определить, на каком именно этапе происходили изменения: уже при переходе от праборейского к праиндоевропейскому или позднее, при развитии языков-потомков.
Эти показатели описывают два различных исторических среза. Их задача локализовать, на каком переходе произошло изменение профиля.
Здесь, на мой взгляд, ключевая фраза именно на каком этапе происходили изменения она хорошо объясняет, зачем вам вообще нужен раздельный двухэтапный расчёт.
5. ЭТАП 1. ПЕРЕХОД ПБ → ПИЕ
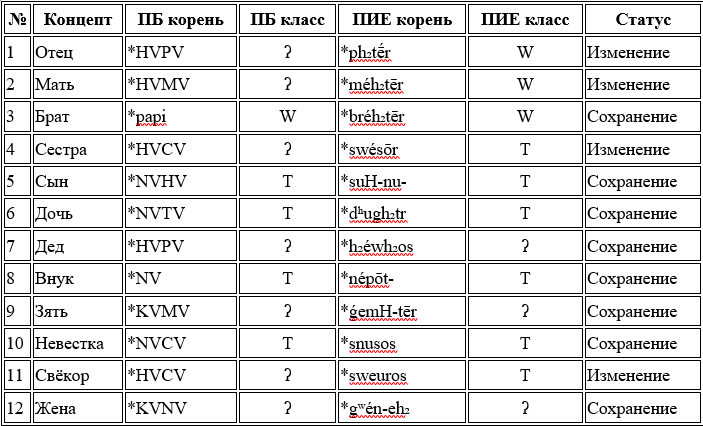
Первый этап предназначен для определения того, какая часть модельного праборейского профиля сохраняется на праиндоевропейском уровне.
Таблица 1. Матрица ПБ → ПИЕ
Концепт | ПБ корень | ПБ класс | ПИЕ корень | ПИЕ класс | Статус | |
1 |
Отец | *HVPV | ʔ | *ph₂tḗr | W | Изменение |
2 |
Мать | *HVMV | ʔ | *méh₂tēr | W | Изменение |
3 | Брат | *papi | W | *bréh₂tēr | W | Сохранение |
4 | Сестра | *HVCV | ʔ | *swésōr | T | Изменение |
5 | Сын | *NVHV | T | *suH-nu- | T | Сохранение |
6 | Дочь | *NVTV | T | *dʰugh₂tr | T | Сохранение |
7 | Дед | *HVPV | ʔ | *h₂éwh₂os | ʔ | Сохранение |
8 | Внук | *NV | T | *népōt- | T | Сохранение |
9 | Зять | *KVMV | ʔ | *ǵemH-tēr | ʔ | Сохранение |
10 | Невестка | *NVCV | T | *snusos | T | Сохранение |
11 | Свёкор | *HVCV | ʔ | *sweuros | T | Изменение |
12 | Жена | *KVNV | ʔ | *gʷén-eh₂ | ʔ | Сохранение |
Количество сохранённых позиций: 8.
Из 12 исследуемых понятий 8 сохранили свой артикуляторный класс.
Поэтому коэффициент сохранения составляет:
8 из 12, или 66,7%.
КС ПБ→ПИЕ = 67%
Для удобства в предыдущем варианте статьи этот результат округлялся до 67%.
5.1. Интерпретация результата
Основной результат первого этапа заключается в том, что праиндоевропейский уровень, согласно принятой модели, сохраняет приблизительно две трети артикуляторно-семантического профиля праборейского уровня.
Наиболее заметные изменения концентрируются в позициях:
При этом Сын, Дочь, Брат, Дед, Внук, Зять, Невестка и Жена сохраняют исходный класс.
Особое значение имеет переход: ʔ → W в терминах Отец и Мать.
В интерпретационной модели это может рассматриваться как смещение от исходного класса происхождения к классу непосредственной телесно-семейной принадлежности.
Однако такое толкование является именно семантической интерпретацией артикуляторного профиля, а не самостоятельным доказательством исторической реконструкции ПИЕ.
6. ПРЯМАЯ ВЕТВЬ: ПБ → ШУМЕРСКИЙ
В принятой модели шумерский язык не рассматривается как индоевропейский язык и поэтому не пропускается через промежуточный этап ПБ → ПИЕ.
Для него применяется непосредственное сравнение: ПБ → ШУМЕРСКИЙ
Таблица 2. Матрица ПБ → шумерский
Концепт | ПБ класс | Шумерское слово | Шум. класс | Статус | |
1 | Отец | ʔ | a-a | ʔ | Сохранение |
2 | Мать | ʔ | ama | ʔ | Сохранение |
3 | Брат | W | e | T | Изменение |
4 | Сестра | ʔ | nin | T | Изменение |
5 | Сын | T | dumu | T | Сохранение |
6 | Дочь | T | dumu.munus | T | Сохранение |
7 | Дед | ʔ | ab-ba | ʔ | Сохранение |
8 | Внук | T | dumu | T | Сохранение |
9 | Зять | ʔ | dam | T | Изменение |
10 | Невестка | T | kur | T | Сохранение |
11 | Свёкор | ʔ | a-a | ʔ | Сохранение |
12 | Жена | ʔ | dam | T | Изменение |
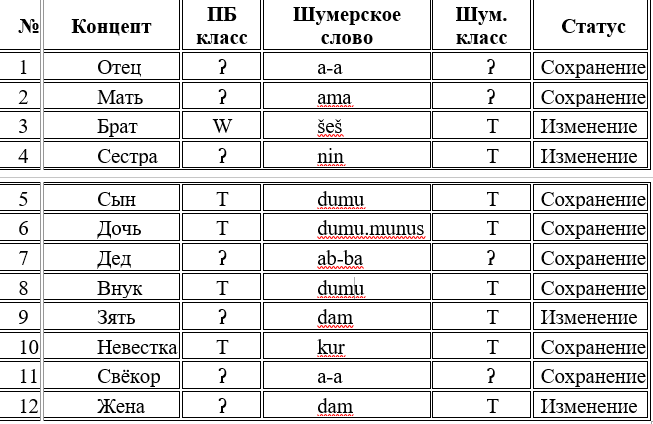
Количество сохранённых позиций: 8.
Следовательно, 8/12 × 100 = 66,7%
То есть 8 сохранённых позиций из 12 составляют 66,7%.
КС → ПБшумерский = 67%
6.1. Артикуляторно-семантическая интерпретация
В данной модели наиболее существенным результатом является сохранение класса в позициях:
Одновременно часть боковых или социальных отношений переходит в T.
В рамках артикуляторно-семантической интерпретации это позволяет выдвинуть гипотезу о сходном направлении структурной перестройки:ʔ / W → T в ряде терминов, связанных с социальными отношениями.
Важно, однако, формулировать этот результат именно как наблюдаемую структурную аналогию, а не как доказательство исторического родства шумерского и индоевропейских языков.
7. ЭТАП 2. ПИЕ ЯЗЫКИ-ПОТОМКИ
После определения перехода ПБ → ПИЕ проводится второй, независимый этап.
Его задача: определить, какую долю ПИЕ-артикуляторного профиля сохраняет конкретный язык.
Таким образом: ПБ → ПИЕ и ПИЕ → языки потомки ПИЕ, рассматриваются как самостоятельные переходы.
8. ПИЕ → ГОТСКИЙ
Для готского языка в принятой выборке фиксируется: 12/12 × 100= 100%
В готском языке сохранились все 12 рассматриваемых позиций из 12. Поэтому степень сохранности составляет 100%.
КС ПИЕ → готский = 100%
Иными словами, в готском материале ни одна из 12 позиций не была утрачена.
В качестве примеров используются:
В рамках метода Рублевского это означает, что фонетическое изменение само по себе не обязательно ведёт к изменению артикуляторного класса.
Особенно важна здесь методологическая идея разделения:
фонетическая форма не равно артикуляторно-семантический класс.
Поэтому даже существенная историческая фонетическая трансформация не должна автоматически считаться семантической трансформацией.
Для готского это позволяет говорить о сохранении выбранного артикуляторного каркаса при изменении конкретного фонетического наполнения лексем.
9. ПИЕ → ВЕДИЙСКИЙ САНСКРИТ
Для ведийского санскрита: 9/12 × 100= 75%
Следовательно: КС ПИЕ → Ведийский = 75%
В принятой матрице изменения отмечены, в частности, для:
Эти позиции в интерпретационной схеме переходят из ʔ в T.
Следовательно, для ведийского языка наблюдается достаточно высокая степень сохранения исходного профиля, но уже имеются отдельные сдвиги в сторону переднеязычного, социально-реляционного класса.
10. ПИЕ → РУССКИЙ
Для русского языка получено: 7/12 × 100 = 58,3%
Соответственно: КС ПИЕ → русский = 58,3%.
В исходной модели изменения затрагивают:
Особое внимание уделяется интерпретации формы отец как позиции, в которой, согласно принятой модели, наблюдается возвращение к гортанному классу.
При этом необходимо отделять историческую фонетику от семантической интерпретации. Само наличие определённого звука в русском слове не доказывает изменения социального статуса соответствующего концепта. Оно лишь позволяет классифицировать начальную позицию в рамках предложенной системы.
Поэтому более строгая формулировка результата: в рассматриваемой выборке русский язык сохраняет 7 из 12 ПИЕ-инициальных артикуляторных классов.
А интерпретация конкретных переходов является следующим уровнем анализа.
11. ПИЕ → АРМЯНСКИЙ
Для армянского языка: 7/12 × 100 = 58,3%
Следовательно: КС ПИЕ → Армянский =58%
В статье учитываются исторические консонантные изменения, в том числе переходы, описываемые через традиционные фонетические соответствия.
В рамках метода Рублевского принципиально важно, что фонетическое изменение должно быть преобразовано в единый классификационный код.
Иными словами, исследователь не сравнивает непосредственно: фонему А = фонема Б, а спрашивает: принадлежат ли начальные позиции обеих лексем к одному артикуляторному классу?
Именно это позволяет отделить фонетическое изменение от изменения исследуемого профиля.
12. ПИЕ → ФРАНЦУЗСКИЙ
Для французского языка в принятой выборке: 6/12 × 100 = 50%
Следовательно: КС_ПИЕ → французский = 50%
В рассматриваемой модели часть исходных T- и ʔ-позиций интерпретируется как перешедшая в W.
Таким образом, французский материал демонстрирует более значительную перестройку начальных артикуляторных классов, чем готский или ведийский.
Однако коэффициент 50% означает только то, что в данной выборке совпадают 6 из 12 классификационных позиций.
Сам по себе этот показатель не означает большую или меньшую историческую ценность языка и не является оценкой развития языка.
13. СВОДНЫЕ РЕЗУЛЬТАТЫ
Поскольку разные строки относятся к разным историческим переходам, сводная таблица не должна интерпретироваться как рейтинг языков.
Таблица 3. Свод коэффициентов сохранения
Язык / уровень | Исторический переход | Сохранено | КС |
Праиндоевропейский | ПБ → ПИЕ | 8/12 | 67% |
Шумерский | ПБ → Шумерский | 8/12 | 67% |
Готский | ПИЕ → Готский | 12/12 | 100% |
Ведийский санскрит | ПИЕ → Ведийский | 9/12 | 75% |
Русский | ПИЕ → Русский | 7/12 | 58% |
Армянский | ПИЕ → Армянский | 7/12 | 58% |
Французский | ПИЕ → Французский | 6/12 | 50% |
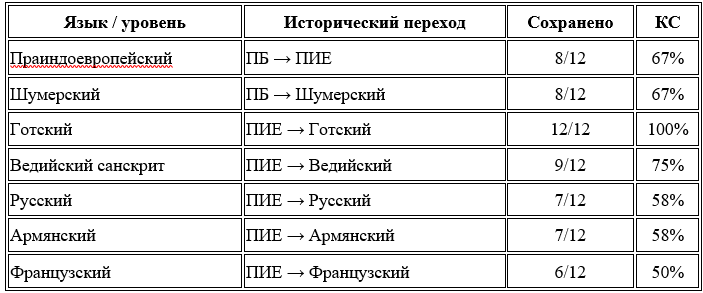
Такая форма представления позволяет видеть не лучший или худший язык, а разную степень совпадения конкретного исторического среза с исходным профилем.
14. ЧТО ИМЕННО ИЗМЕРЯЕТ МЕТОД РУБЛЕВСКОГО А.В.
Метод Рублевского в данной работе измеряет не языковое родство в общепринятом сравнительно-историческом смысле. Он измеряет: степень сохранения определённой классификационной структуры инициальных артикуляторных классов внутри заранее выбранного семантического поля. Это принципиальное уточнение. Коэффициент 100% означает: во всех 12 позициях класс начальной артикуляции совпал. Коэффициент 50% означает: совпали 6 из 12 позиций.
Поэтому КС следует понимать, как индекс сохранения артикуляторно-семантического профиля, а не как процент генетического родства языка с реконструируемым предком.
15. РАЗДЕЛЕНИЕ ФОНЕТИЧЕСКОГО И СЕМАНТИЧЕСКОГО УРОВНЕЙ
Одним из принципиальных положений метода является разграничение:
Например, историческое изменение фонемы может не менять класса:
W → W
В этом случае:
Напротив: ʔ → T означает изменение классификационной позиции, независимо от того, насколько близки конкретные звуки по традиционной фонологической системе.
Именно поэтому метод Рублевского позволяет рассматривать историческое развитие через уровень классов, а не только через последовательность фонем.
16. КОНВЕРГЕНТНЫЕ ТЕНДЕНЦИИ
Особый интерес представляет сопоставление двух независимых переходов: ПБ→ПИЕ и ПБ→Шумерский. Оба дают: 67%. Однако одинаковый коэффициент ещё не означает идентичность исторического процесса.
Важно различать: численное совпадение результата и совпадение механизма его получения.
В ПИЕ изменение происходит в одном историко-языковом процессе, тогда как шумерский рассматривается как независимая ветвь.
Тем не менее совпадение общей доли сохранённых позиций позволяет выдвинуть гипотезу о структурной конвергенции, то есть о возможности независимо сходных изменений внутри лексики родства.
Особенно интересны случаи, в которых разные языковые системы демонстрируют переходы к T в позициях, связанных с социальным отношением.
На этом уровне артикуляторно-семантический анализ может использоваться как инструмент постановки дальнейших сравнительных вопросов.
17. ОГРАНИЧЕНИЯ МЕТОДА
Для научной интерпретации необходимо учитывать ряд ограничений.
17.1. Зависимость от реконструкции
Праборейские формы являются реконструкционными и зависят от принятой гипотезы. Поэтому изменение праборейского материала способно изменить и итоговый КС.
17.2. Зависимость от классификации
Три класса ʔ, W и T являются исследовательской системой кодирования. Следовательно, разные классификационные решения потенциально могут привести к другим результатам.
17.3. Размер выборки
В исследовании используется только 12 концептов.
Следовательно, изменение одной позиции изменяет итоговый коэффициент на: 1/12 × 100 = 8,33%. То есть одна позиция составляет 8,33% всей выборки. Поэтому добавление, исключение или изменение оценки даже одного концепта может заметно изменить итоговое значение коэффициента.
Это означает, что результаты чувствительны к единичным решениям, связанным с классификацией и сопоставлением отдельных позиций.
17.4. Семантическая интерпретация не тождественна фонетике
Отнесение начального звука к классу T или W не доказывает автоматически наличие у носителей языка соответствующей концептуальной категории.
Связь между классом и семантическим содержанием является интерпретационной гипотезой метода.
17.5. КС не является самостоятельным доказательством генетического родства
Высокий коэффициент сохранения может возникнуть по различным причинам.
Поэтому артикуляторно-семантический коэффициент должен использоваться как дополнительный аналитический показатель, а не как замена сравнительно-историческому методу.
18. НАУЧНАЯ ИНТЕРПРЕТАЦИЯ ПОЛУЧЕННЫХ ДАННЫХ
Полученные результаты позволяют сделать несколько выводов.
18.1. Праборейский → праиндоевропейский
В принятой реконструкции сохраняется 8 из 12 позиций: 66,7%.
Наибольший интерес представляют изменения в ядерной семейной лексике, прежде всего Отец и Мать, а также Сестра и Свёкор.
18.2. Праборейский → шумерский
Наблюдается такой же коэффициент: 66,7%. При этом распределение сохранений и изменений отличается от ПБ → ПИЕ. Следовательно, одинаковый КС не означает идентичности профиля.
18.3. ПИЕ → готский
В принятой матрице: 100%. Это наиболее высокая степень сохранения исследуемой структуры среди рассматриваемых языков.
18.4. ПИЕ → ведийский
Получено: 75%. Профиль в значительной степени сохраняется, но часть позиций демонстрирует переход в T.
18.5. ПИЕ → русский и армянский
Для обоих языков: 58,3%. Это означает сохранение 7 из 12 выбранных классификационных позиций.
18.6. ПИЕ → французский
Получено: 50%. Здесь совпадает половина выбранной матрицы.
19. МЕТОДОЛОГИЧЕСКОЕ ЗНАЧЕНИЕ МЕТОДА РУБЛЕВСКОГО А.В.
Предлагаемый метод может быть представлен как дополнительный уровень анализа между фонетическим материалом и широкими культурно-семантическими интерпретациями.
Его структура:
фонетическая форма → артикуляторный класс → инициальный профиль → сравнение концептов → количественный показатель
При этом метод обладает несколькими особенностями.
20. ОБСУЖДЕНИЕ
Основным результатом данной работы является не утверждение о том, что три артикуляторные зоны непосредственно кодируют человеческие понятия, а демонстрация того, что авторскую систему можно превратить в формальную сравнительную процедуру.
В этом качестве метод Рублевского имеет следующую структуру:
1. Кодирование.
Каждый термин получает код: [ʔ, W, T]
2. Построение профиля.
Из множества концептов строится последовательность классов.
3. Сопоставление.
Сравниваются последовательности исторически связанных или гипотетически сопоставляемых языковых уровней.
4. Бинарная фиксация.
Для каждой позиции определяется: совпадение по классу, сохранение = 1 или не совпадение по классу, не сохранение = 0.
5. Количественная оценка.
Рассчитывается:
Здесь обозначения такие:
КС = (Σ Sᵢ / N) × 100%
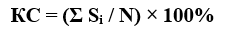
где:
Если каждая позиция оценивается просто как 1 = сохранилась и 0 = не сохранилась, то ΣSᵢ фактически означает количество сохранённых позиций.
6. Интерпретация.
Только после получения числового результата рассматриваются направления структурных изменений. Эта последовательность существенно важнее самого итогового процента, поскольку делает процедуру потенциально воспроизводимой.
21. ФУНДАМЕНТАЛЬНЫЕ РЕЗУЛЬТАТЫ
В рамках предложенной модели можно сформулировать следующие результаты.
1. Сохранение класса T в детской лексике
Концепты Сын и Дочь на рассматриваемых уровнях сохраняют T-класс.
Это наблюдение представляет интерес для дальнейшего исследования, поскольку может свидетельствовать о высокой устойчивости определённой позиции в выбранной семантической области. Однако для утверждения об абсолютной устойчивости необходимо существенно расширить корпус.
2. Уязвимость класса ʔ
В ряде рассматриваемых переходов именно позиции, первоначально отнесённые к ʔ, демонстрируют заметные изменения. Это позволяет поставить вопрос о том, является ли гортанный класс статистически более изменчивым. Для ответа необходим расширенный массив данных.
3. Разделение фонетического и классификационного уровней
Метод показывает возможность ситуации:
фонетическое изменение не равно - изменение артикуляторного класса
Это один из центральных методологических принципов исследования.
4. Возможность конвергентного анализа
Совпадение КС для ПБ → ПИЕ и ПБ → шумерского: 66,7% может быть рассмотрено как основание для дальнейшей проверки гипотезы о сходных направлениях структурной перестройки. Само по себе такое совпадение ещё не доказывает общего происхождения.
22. ЗАКЛЮЧЕНИЕ
Раздельный двухэтапный артикуляторно-семантический анализ, выполненный по методу Рублевского, позволяет представить историческую динамику терминов родства в форме формализованной матрицы.
Главным преимуществом предложенного подхода является разделение трёх уровней:
фонетического материала артикуляторного класса семантической интерпретации.
На первом этапе было получено:
Исторический переход | Сохранено | КС |
ПБ → ПИЕ | 8/12 | 67% |
ПБ → Шумерский | 8/12 | 67% |
ПИЕ → Готский | 12/12 | 100% |
ПИЕ Ведийский | 9/12 | 75% |
ПИЕ → Русский | 7/12 | 58% |
ПИЕ → Армянский | 7/12 | 58% |
ПИЕ → Французский | 6/12 | 50% |
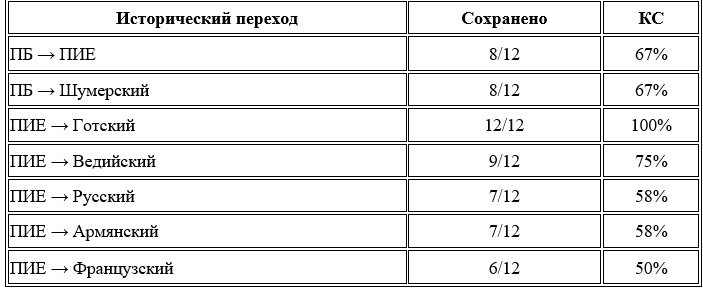
Эти значения следует понимать, как показатели степени сохранения выбранной артикуляторно-семантической классификационной структуры, а не как показатели генетического родства языков.
Наиболее перспективным направлением дальнейшей работы является расширение корпуса с 12 до нескольких сотен лексем, формирование автоматизированной базы начальных профилей и статистическая проверка того, действительно ли распределение классов ʔ, W и T связано с семантическими полями неслучайным образом.
Таким образом, метод Рублевского А.В. может быть представлен как формализуемая исследовательская процедура артикуляторно-семантического кодирования, которая потенциально позволяет объединить сравнительно-исторический анализ, статистическое моделирование и компьютерную обработку больших массивов лексического материала.
Эта версия уже гораздо строже отделяет сам метод Рублевского А.В., расчёт КС и последующую культурно-семантическую интерпретацию. Для научной статьи это существенно сильнее первоначального варианта.
ИСТОЧНИКИ
|